
El alojamiento de imágenes en este blog siempre ha sido un problema. Una cosa son las fotos premium, las que por sí solas son a thing, otra cosa son las fotos de soporte y otra muy diferente son las imágenes de cualquier otro tipo (que no necesariamente son fotos).
Las fotos premium tienen su propia vida, algunas en flickr, algunas en instagram, algunas en las dos. Y de esas, algunas caen al blog como entradas independientes en fotoblog o son parte de un artículo en forma que las usa. Y durante muchos años lo que hacía era subirlas a cualquier servicio y desde allí invocarlas en el blog, pero, por ejemplo, Instagram nunca lo ha hecho sencillo, estándar, convention-compliant o, siquiera, amable.
En los artículos, además, uso fotos buenas pero que no lucen por sí solas tanto pero ayudan a dar contexto de lo que uno intenta explicar, no digo que sean malas, sino que son sólo útiles, no suficientes. Esas son las fotos de soporte y normalmente las subía al blog y desde allí las servía.
Hoy, una de las razones que más contento me tienen con la migración es poder conectar img.pro al proceso de escritura y creación de contenido optimizando brutalmente el uso de ancho de banda del blog.
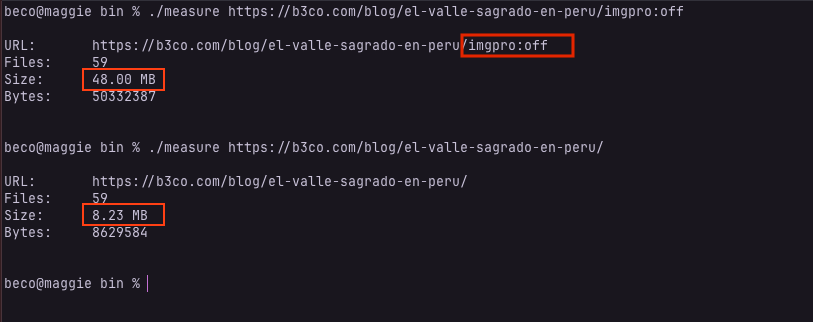
Con una cosa extra, muy diferente a intentos anteriores: las imágenes originales se almacenan íntegramente en mi propio servidor, desde img.pro sólo sirvo una copia optimizada en tamaño, calidad y caché distribuido.
img.pro
img.pro es un servicio creado por Cristian Castillo (twt, web) que me tocó ver nacer y poco a poco mutar a un producto puntual e increíble que promete algo aparentemente sencillo pero potente y muy necesario: un lugar centralizado para manejar tus imágenes, optimización, transformaciones y serving de forma óptima. Y lo logra.
Es importante entender los algoritmos de optimización de imágenes para no asumir que todas las imágenes se pueden llevar al 3% de su tamaño original, algunas son 5, otras 10, otras 30 y algunas, muy poco uniformes (como la de este encabezado) sólo se comprimen un a un 45% de su tamaño original, 3.2MB → 1.44MB.
Kirby y su filesystem
Kirby tiene una forma sui generis de almacenar la información bastante old school pero aprovecha muy bien el poder de CPUs: en archivos y carpetas
content/                 <-- todo el contenido está bajo esta carpeta
├── 1_acerca/            <-- cada página tiene su propia carpeta
│   ├── default.txt      <-- dentro de esta carpeta está el nodo(1) y...
│   ├── image1.jpg       <-- todos los archivos auxiliares para presentar
│   │                            en cada entrada
│   ├── image1.jpg.txt   <-- por cada archivo (imagen, pdf, zip, lo que sea,
│   │                            va guardando un archivo con metadatos
│   ├── image2.jpg
│   ├── image2.jpg.txt
│   └── ...
└── 2_archivo/
│   └── default.txt
└── blog/                <-- hay una carpeta especial para el tipo "blog"
    ├── articulo_1/      <-- en donde cada entrada, igual, tiene su propia
    │   │                        carpeta con su propio contenido
    │   ├── article.txt  <-- tiene su propio nodo, llamado diferente
    │   ├── foto1.jpg
    │   ├── foto1.jpg.txt
    │   ├── foto2.jpg
    │   ├── foto2.jpg.txt
    │   └── ...
    ├── articulo_2/
    │   ├── article.txt
    │   ├── foto20.jpg
    │   ├── foto20.jpg.txt
    │   └── ...
    └── ...
Es decir, cuando escribo un artículo y le voy agregando imágenes, éstas se van subiendo a la misma carpeta donde está guardado el archivo con el texto y, originalmente, no hace nada más, desde allí mismo las va sirviendo. Y ese fue el proceso que optimicé.
Proceso de escritura
- escribo todo desde el panel del blog (Kirby)
- allí mismo voy agregando fotos, todas quedan con el metatag (de kirby)
(image:donde elurlpuede ser relativo o absoluto (esto es importante)- algunas las invoco desde flickr (url absoluto)
- algunas las subo directamente desde el editor de texto (url relativo)
- las que vienen de flickr, así se quedan, su sistema de nomenclatura e invocación es una joya que no ha cambiado en más de 20 años
- las que subo al blog se guardan como lo harían normalmente en el filesystem junto con su archivo de metadatos, pero una vez registradas, se dispara el evento
afterUpload - un plugin mío cacha el
afterUploady, si laurles relativa- toma la imagen y la encola para subir a img.pro usando su API
- toma la
urlque img.pro le asigna y se lo agrega como metadatodeliveryUrl
- a la hora de servir la imagen, si no tiene el atributo
deliveryUrlusa el url (de mi propio servidor), pero si sí lo tiene, resuelve desde allá y la magia sucede
Queues
Como Kirby no tiene colas en sí, tuve que hacer un queue system a base de directorios + archivos.json + cron (* * * * *, porque no hay cpu que ahorrar). Me recordó mis viejos tiempos en MA o en SFO con Perl al 200%.
La migración
Tras un par de horas de estar pegándole al API de img.pro conseguí algo que no recuerdo si alguna vez antes lo había logrado: tener TODAS las imágenes del blog (que no se hayan perdido en migraciones) en un solo lugar. Todas. Las 3 mil imágenes. No sólo en un mismo lugar, sino bien referenciadas internamente, respaldables e indexables en un filesystem adecuado. Esto no es poca cosa.
Como dato cultural: en promedio las imágenes usadas en este blog desde 2018 a la fecha es de 1.7 MB. El promedio de dichas imágenes servidas desde img.pro es de 112 KB, ~6% del peso original.
